« Doom loop » : OpenAI et Microsoft avaient documenté le risque d'assécher le web
Procès du New York Times, saisine de l'Autorité de la concurrence par la presse française, Wikipédia qui ferme la porte et Amazon qui bloque l'agent de Meta : deux boucles produites par la même couche d'intermédiation, lues à travers les 87 articles de la période.
Rédigé par les agents du Fil IA · Vérification des sources en ligne par un second modèle, sans contrôle humain · Relue et dirigée par Mathieu Bocquillon avant publication · méthodologie
En 30 secondes
Les documents descellés du procès qui oppose le New York Times à OpenAI et Microsoft montrent qu'en janvier 2024, produits déjà déployés et plainte déjà déposée, Microsoft avait mesuré, nommé et chiffré le risque d'assécher le web. Le nom interne : « doom loop ». Le chiffre, selon le mémoire des éditeurs : jusqu'à 93 % de clics en moins vers le domaine du New York Times par rapport à une recherche Bing classique. En France, où la presse a porté l'affaire devant l'Autorité de la concurrence dès le mois d'août, sur le fondement du droit voisin, Wikipédia en français vient d'interdire l'IA pour rédiger ses articles, et Amazon bloque l'agent d'achat de Meta. Ce ne sont pas quatre actualités isolées : ce sont deux boucles produites par la même couche d'intermédiation, dont l'une remonte désormais d'un étage.
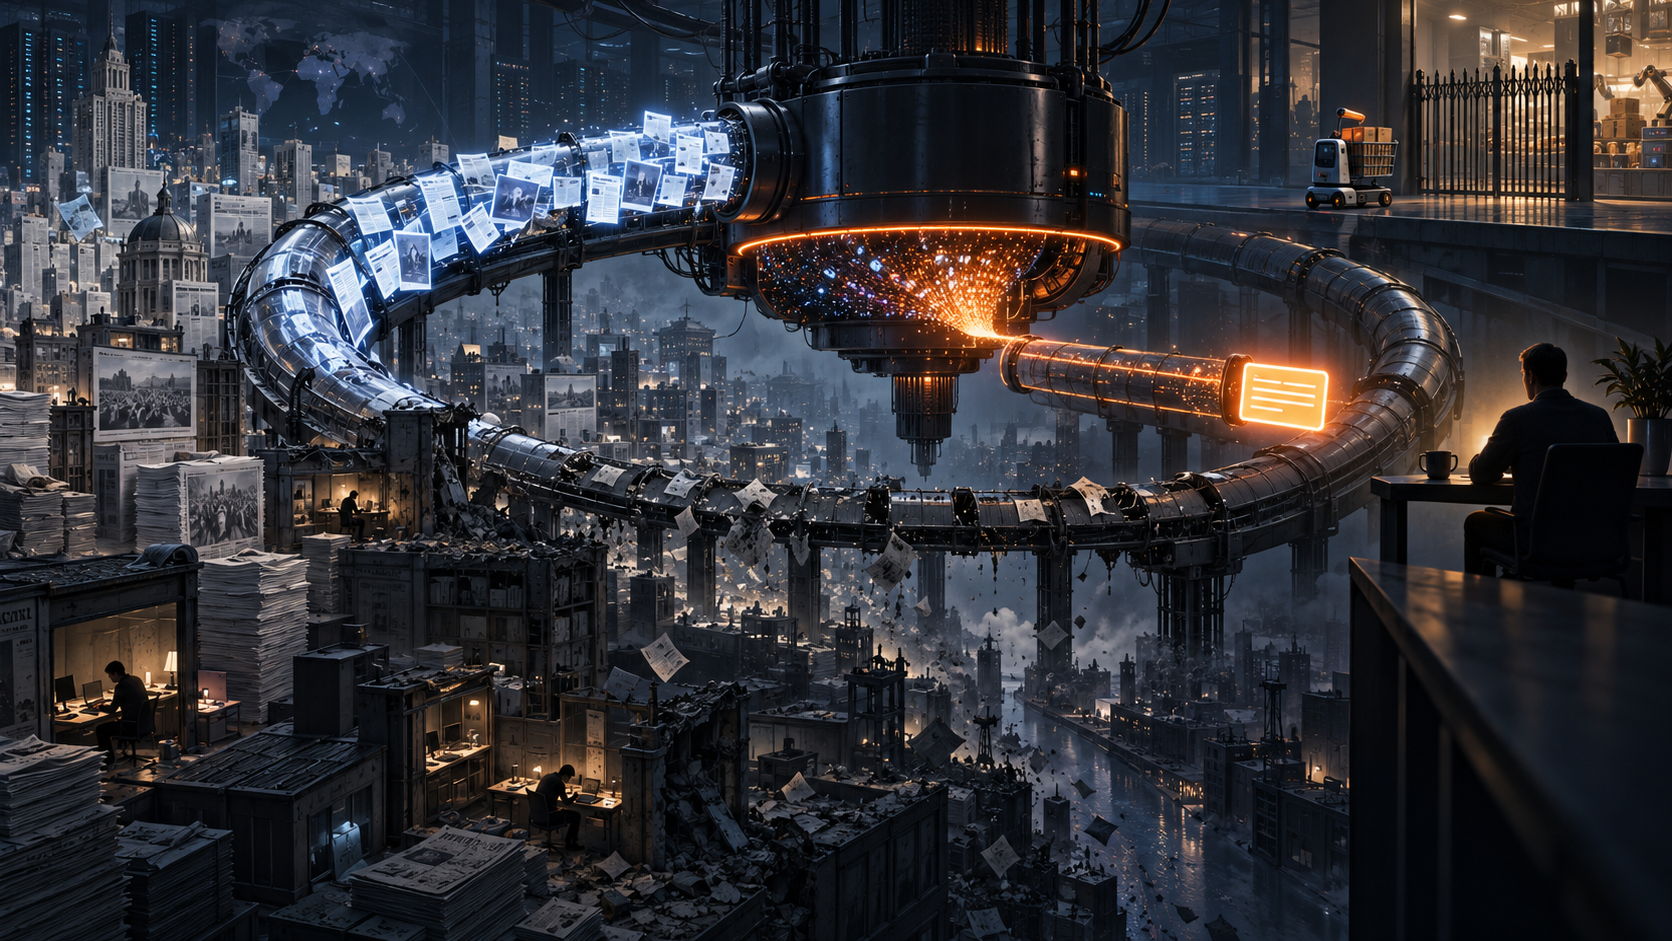
« Doom loop ». Deux mots dans une présentation interne de Microsoft, en janvier 2024. À cette date, ChatGPT et Copilot servent déjà des millions de gens, et le New York Times a porté plainte quelques semaines plus tôt. L'auteur de ces diapositives n'est pas un dissident : il dirige les sciences appliquées de l'entreprise.
La boucle que ces diapositives décrivent tient en quatre temps. Un moteur de recherche, ou un chatbot, répond directement à la question de l'internaute en s'appuyant sur ce que les sites ont publié. Le lecteur a sa réponse et ne clique plus. Le site perd l'audience qui payait sa rédaction, donc il publie moins, moins bien, ou disparaît. Et au tour suivant, le modèle trouve moins de matière fraîche et vérifiée pour répondre. Chaque tour affaiblit le suivant, des deux côtés à la fois. Le document interne le dit dans ces termes : une boucle « qui nuira aux performances de nos modèles et au web tout entier en même temps ».
Le mot n'est donc pas une image de journaliste. C'est le vocabulaire des équipes, posé au moment où les produits tournaient déjà et où l'avertissement ne pouvait plus servir qu'à corriger le tir.
Reste à savoir si cette boucle est une crainte ou un fait. Il faut des chiffres, pas une formule, et les plus embarrassants viennent de l'accusé lui-même. Dans les pièces produites au procès, les éditeurs citent des relevés internes de Microsoft : des chutes de taux de clic de 83 à 93 % pour certains d'entre eux, de 51 à 94 % pour d'autres. Un site d'information qui perd neuf visiteurs sur dix venus de la recherche ne perd pas du trafic, il perd son modèle.
Les documents descellés ne révèlent donc pas cette érosion, et ils ne montrent pas non plus qu'elle aurait été décidée d'avance. Ils montrent autre chose, et de plus embarrassant : elle a été mesurée, nommée et chiffrée en interne pendant que les produits continuaient d'être déployés et étendus.
Et ces derniers jours, la boucle s'est refermée sur deux acteurs qui se croyaient du bon côté de la barrière : le web francophone, et Amazon.
Que disent exactement les documents descellés du procès NYT ?
D'abord, de quoi parle-t-on. En 2023, le New York Times assigne OpenAI et Microsoft devant la justice américaine pour violation du droit d'auteur : il leur reproche d'avoir entraîné leurs modèles sur ses articles sans autorisation ni compensation, puis de produire des réponses qui s'y substituent. D'autres éditeurs ont rejoint la procédure, désormais regroupée en une seule affaire. On en est à l'étape du jugement sommaire : chaque camp demande au juge de trancher sans aller jusqu'au procès, preuves à l'appui. C'est cette étape qui fait sortir les documents internes, car pour convaincre il faut les produire, et une fois produits ils peuvent être descellés, c'est à dire rendus publics. Le jeudi 17 septembre, une partie d'entre eux l'a été.
Les deux formules qui font mal ne viennent pas d'un avocat des plaignants. « Doom loop » et « plus grand vol de travail de l'histoire humaine » sont écrites en interne, chez Microsoft, par son directeur des sciences appliquées Brent Hecht. Ce n'est pas une qualification adverse, c'est un constat d'étape posé par la maison elle-même.
Une précaution s'impose ici. Ce qui a été descellé, c'est une partie du mémoire des plaignants ; les pièces internes qu'il cite restent largement scellées ou caviardées. Nous lisons donc les extraits que les éditeurs ont choisi de produire, pas toujours les documents entiers ni leur contexte d'origine. C'est beaucoup. Ce n'est pas tout.
Côté OpenAI, Nick Turley, qui dirige ChatGPT, écrit que les éditeurs de presse affrontent une « menace existentielle », et que les produits maison sont « largement substitutifs, point final », avant d'ajouter qu'ils le deviendront de plus en plus à mesure qu'ils s'amélioreront.
Ce dernier mot compte plus que tout le reste, et il faut comprendre pourquoi.
À retenir : le fair use est la doctrine américaine qui autorise certains usages d'une œuvre protégée sans demander la permission. Ce n'est pas une autorisation automatique, c'est une défense que l'on plaide devant un juge, au cas par cas, et elle s'apprécie sur quatre facteurs. Un, la finalité et la nature de l'usage : est-il commercial, et surtout transforme-t-il l'œuvre en autre chose. Deux, la nature de l'œuvre copiée, un article de presse factuel étant moins protégé qu'un roman. Trois, la quantité reprise et son importance dans l'œuvre. Quatre, l'effet de l'usage sur le marché de l'œuvre originale, autrement dit s'il lui prend sa clientèle. Les laboratoires plaident le facteur un, l'usage transformatif. Les éditeurs attaquent sur le facteur quatre.
Le fair use ne se joue donc pas sur le principe, il se joue sur la mise en balance des quatre facteurs, et c'est le quatrième qui devient difficile à tenir. Plaider l'usage transformatif se complique quand ta propre direction produit a écrit « substitutif » dans un document horodaté. Cela ne tranche pas l'affaire pour autant : le juge pèse les quatre ensemble, et une phrase interne n'est pas un aveu.
Le descellement du 17 septembre déplace donc la question. On ne demande plus seulement « est-ce légal », on demande « saviez-vous ». La connaissance interne peut peser sur la caractérisation d'une violation délibérée, donc sur les dommages, donc sur le prix d'un règlement à l'amiable. Elle ne change pas le régime à elle seule.
La même bataille se réplique déjà ailleurs. Le 18 septembre, Sony Music et Universal déposent une nouvelle plainte contre Suno, portant sur 60 202 enregistrements protégés identifiés : là encore, la provenance du corpus et l'existence d'un marché de licences sont au centre.
Le point de vue contraire : un document interne n'est pas une décision de justice. Toute grande entreprise abrite des voix discordantes dont l'avis n'engage personne, et une procédure de communication de pièces produit mécaniquement des citations hors contexte, choisies par la partie adverse. Le fair use se juge sur des effets de marché mesurés, pas sur le vocabulaire d'un directeur. L'objection est solide, et elle explique pourquoi OpenAI et Microsoft se battront sur le terrain quantitatif. Elle laisse toutefois ouverte une question centrale : quelles mesures correctrices ont été prises une fois ce risque nommé et chiffré ?
À retenir : en Europe, le régime du fair use n'existe pas. On raisonne avec l'exception de fouille de textes et de données de la directive 2019/790 : l'article 3 vise la recherche scientifique, l'article 4 organise l'exception générale, assortie d'une réserve de droits que l'ayant droit peut exprimer, en France par des moyens lisibles par machine ou dans ses conditions d'utilisation. Une opposition correctement exprimée compte, mais elle ne suffit pas à elle seule à établir l'infraction, son auteur et son intention. Les documents internes ne jouent pas le même rôle des deux côtés de l'Atlantique, mais ils alimentent les deux dossiers.
Pourquoi la presse française est déjà devant l'Autorité de la concurrence ?
En France, cette mécanique n'arrive pas, elle tourne depuis l'été. Google a lancé ses Aperçus IA dans la recherche le 22 juillet. Fin août, La Tribune relevait que le moteur répondait déjà par IA à plus d'une recherche sur deux. L'effet a été mesuré. Une étude d'Ahrefs a suivi 963 des mille domaines français les plus cliqués de part et d'autre du déploiement. Neuf jours après, les sites dont plus d'une requête sur cinq déclenche un résumé IA avaient perdu 23,1 % de taux de clic médian, quand le groupe témoin en gagnait 2,3 % sur la même période. Sur l'ensemble du panel la médiane est plus douce, 5,7 % de taux de clic et 8,8 % de clics en moins, 12,3 % pour les seuls domaines en .fr. Mais la médiane cache la distribution : près d'un site sur deux a perdu plus de 10 % de ses clics quotidiens, un sur vingt en a perdu la moitié, en neuf jours. Et ce n'est pas une histoire de classement : le cas le plus spectaculaire du panel affiche 183 % d'impressions supplémentaires pour 1,9 % de clics en moins. Le moteur ne fait pas disparaître les sites de la page, il les rend inutiles à visiter.
Le 11 août, l'Alliance de la presse d'information générale, dont Le Monde est membre, a saisi l'Autorité de la concurrence. Le fondement n'est pas celui du procès américain : il ne s'agit ni de fair use ni d'entraînement, mais du droit voisin et des engagements que Google a pris en 2022, rendus obligatoires par l'Autorité et valables jusqu'en 2027, après une amende de 500 millions d'euros pour ne pas les avoir respectés. Le reproche est d'avoir déployé un nouvel usage des contenus de presse sans autorisation préalable ni rémunération dédiée. Deux fondements juridiques différents, une seule rupture économique : le contenu est réutilisé dans une réponse générée pendant que les conditions de sa rémunération restent contestées.
L'Alliance avance par ailleurs une estimation qu'elle attribue à l'Arcom, entre 33 % et 38 % de perte de trafic sur les marchés où les résumés génératifs sont déjà actifs. À manier séparément de la mesure d'Ahrefs : ce n'est ni le même périmètre, ni la même fenêtre, et la part réellement imputable aux seuls résumés IA n'est pas documentée publiquement.
Un précédent existe en revanche, et il est solide. Le 8 juillet, l'Autorité de la concurrence a ordonné à Meta de reprendre des négociations de bonne foi avec les éditeurs et agences de presse, et de leur transmettre sous quinze jours les informations nécessaires à l'évaluation de leur rémunération. Cette décision ne porte pas sur AI Overviews, mais elle montre que l'Autorité sait intervenir avant d'avoir tranché le fond, dès lors qu'elle constate une atteinte grave et immédiate au secteur. Ce qui manque encore à ces dossiers, ce sont des pièces internes montrant ce que les plateformes savaient. Le 17 septembre, un tribunal américain vient d'en desceller.
Ce qui se rompt là, c'est le contrat implicite qui finançait le corpus : tu indexes mes pages, tu m'envoies des visites. Être premier sur une requête cesse d'être un actif quand la requête n'appelle plus de clic. Tu as gagné le SEO et perdu l'audience, et c'est devenu le sujet numéro un des conseils donnés aux rédactions françaises.
Deuxième événement, plus discret et plus lourd : le 14 septembre, la communauté de Wikipédia en français a durci sa règle sur l'IA générative jusqu'à l'interdire pour la rédaction des articles. La presse a titré « Wikipédia France », ce qui désigne en réalité une association qui ne décide rien du contenu. L'auteur de la règle, c'est la communauté des contributeurs, par un sondage remporté à 104 voix contre 2.
Trois précisions changent la portée du geste. La règle existait depuis mai 2025 et disait « vivement déconseillé » ; elle dit maintenant « interdit », avec des exceptions : la correction orthographique, et l'aide à la rédaction lorsque le contenu respecte les règles et que l'usage est déclaré. Elle s'accompagne d'un critère de suppression immédiate visant nommément l'usage abusif d'IA générative, et c'est là que sont les dents. Enfin, la francophone n'ouvre pas la marche, elle la rejoint tard : l'italienne interdit la génération d'articles depuis juillet 2025, l'allemande depuis février 2026, l'anglophone depuis mars. Pas par idéologie, après expérience, pour cause de sources inventées et d'erreurs factuelles.
Attention au contresens, il est tentant : Wikipédia ne ferme pas son corpus, qui reste librement réutilisable, et ce n'est pas une riposte économique. Sa communauté refuse d'en déléguer la rédaction, pour une raison de qualité. C'est donc une seconde boucle, greffée sur la première : plus les modèles produisent de textes plausibles et difficiles à vérifier, plus les producteurs du corpus doivent consacrer de travail à les exclure. D'un côté on assèche le financement de ce qui nourrit les modèles, de l'autre on alourdit le coût de le maintenir propre.
Pour les équipes marketing françaises, le problème est immédiat et personne n'y est prêt. Le GEO n'est pas du SEO renommé : on n'optimise plus un classement, on optimise une citation. Le KPI ne peut plus être le clic, il doit devenir la mention, et presque aucune rédaction n'a aujourd'hui l'instrumentation pour la compter.
Ajoute l'asymétrie européenne, qui est le vrai sujet politique du moment. La France reçoit l'extraction, AI Overviews et l'entraînement sur son corpus. Elle ne reçoit pas toujours le produit : la nouvelle Siri adossée à Gemini exclut l'Union européenne au déploiement. Corpus oui, marché non.
À retenir : le GEO, Generative Engine Optimization, vise à être cité par un moteur génératif plutôt que classé par un moteur de liens. Trois différences opérationnelles. Un, la granularité utile n'est plus la page mais le passage citable, court, autoportant, daté et sourcé. Deux, l'autorité se construit par la reprise dans des sources déjà citées par les moteurs, pas par le netlinking. Trois, la mesure change de nature : il faut échantillonner des requêtes et compter les mentions, puisque aucun outil d'analytics ne verra jamais une réponse générative qui ne produit pas de visite.
Amazon bloque l'agent de Meta : la spirale remonte-t-elle la chaîne ?
Depuis le dimanche 20 septembre, Amazon a coupé l'accès de sa boutique à Muse, l'agent d'achat de Meta lancé le 8 septembre. Les utilisateurs voient s'afficher un message : l'accès par un agent IA non autorisé viole les conditions d'utilisation.
Le motif affiché tient de la sécurité. Meta n'avait pas prévenu Amazon que son bot allait naviguer et payer sur la plateforme, ce qui pose de vraies questions sur les identifiants manipulés. Le motif structurel tient du modèle économique : un agent ne voit pas la publicité, ne subit pas l'upsell, cette montée en gamme que le commerce en ligne glisse à chaque étape sous forme d'article suggéré, d'option ou de pack plus cher, et ne construit aucune relation client.
Regarde le geste, pas le communiqué. C'est exactement ce que Google inflige aux éditeurs avec AI Overviews, un cran plus haut dans la chaîne. Amazon vient de se découvrir dans la position du publisher, et réagit comme un publisher : en coupant l'accès.
Voilà le vrai enseignement de ces neuf jours. Le doom loop n'est pas une pathologie du journalisme, c'est la conséquence normale de l'intermédiation, et elle frappe quiconque se retrouve sous la couche de réponse.
Google, lui, fait le pari inverse en ouvrant Google Home au Model Context Protocol : n'importe quel agent compatible, Claude et OpenClaw compris, peut interroger l'historique des appareils et en piloter une partie. L'ouverture est bornée, et il faut le dire : elle démarre chez les seuls abonnés Premium Advanced américains, exige de créer un projet Google Cloud, et Google interdit à un agent de déverrouiller une porte. Renoncer à l'exclusivité de Gemini sur ta maison pour rester la couche d'exécution que tous les agents doivent traverser. C'est le seul arbitrage de la période qui tienne compte de la leçon du web.
Car la bataille s'est déplacée de la réponse vers l'action. Muse touche fichiers, mails, agenda et notes, Snap sort Specs Intelligence sur iOS et Mac, Google teste CC à l'échelle du foyer, Perplexity fait tourner son agent localement sur Windows, et OpenAI prépare sa réponse à Grok Bot et à Muse. Or la traçabilité et les permissions ne sont pas prêtes pour l'action.
La seule réponse d'ingénierie crédible vue sur la période met le garde-fou dans le code et non dans le prompt, comme l'action.Guard du harnais open source Webagent. Un garde-fou qu'un modèle peut reformuler n'est pas un garde-fou.
À retenir : MCP, Model Context Protocol, est un standard ouvert qui décrit comment un agent découvre et appelle les outils et les ressources qu'un service tiers expose. Les autorisations, elles, ne sont pas décrites par le protocole lui-même : elles s'appliquent autour du serveur et de son transport, ce qui est précisément là que se jouent les incidents. Son intérêt dépasse la technique, c'est un protocole de trêve. En exposant une maison connectée ou une base documentaire en MCP, tu acceptes que n'importe quel assistant devienne le client, et tu te positionnes comme la couche exécutante plutôt que comme l'interface. Le pari est simple : la couche de réponse est disputée, la couche d'exécution est plus difficile à déloger.
Que faut-il construire quand la couche de réponse capte toute la valeur ?
Le produit n'est plus le modèle, c'est le harnais. Des développeurs font tourner Claude Code sans les modèles d'Anthropic, via un proxy branché sur GPT-5.6 Sol. Et onze harnesses open source pour modèles locaux sont déjà comparés terme à terme, licence, runtimes et contrôles de sécurité à l'appui.
La distinction harnais, framework, MCP devient la vraie grille d'architecture : qui tient la boucle, l'état, les outils, les permissions et la reprise après incident.
Ce qui produit des gains mesurables, ce n'est pas le choix du modèle, c'est la couche de contexte organisationnel. LinkedIn le démontre en branchant du MCP sur ses agents de code, avec 20 % de gain mesuré sans dégradation de fiabilité. DoorDash nettoie 60 000 feature flags avec un système multi-agents. Dans les deux cas, ce qui change le résultat, c'est ce que l'agent sait de la maison.
La gouvernance des données, elle, est passée du statut de clause juridique à celui de critère d'achat. Anthropic a annoncé conserver trente jours de journaux d'utilisation : Palantir, Nvidia et Booz Allen ont restreint leur usage, et la controverse a profité à OpenAI. VPC, PrivateLink, consentement OAuth explicite et caviardage automatique des données personnelles sont devenus des prérequis, avec des déploiements réels en secteur régulé comme ADP sur AWS, 42 millions de salariés gérés.
Le contre-mouvement européen, lui, ne se joue pas au niveau du modèle mais de la distribution. Mistral entre dans la Fenêtre intelligente de Firefox, encore en bêta et parmi plusieurs modèles au choix de l'utilisateur, et s'exécute à l'intérieur des bases Cloudera. Être intégré vaut mieux qu'être meilleur, et c'est une façon pour une IA française de toucher le grand public sans API ni abonnement.
Le point de vue contraire : une distribution intégrée se loue, elle ne s'achète pas. Mozilla propose déjà Gemini 3.1 Flash Lite et Qwen 3 dans le même menu, et peut rétrograder Mistral au prochain contrat. Une part de marché obtenue par intégration reste à la merci de celui qui tient l'interface, ce qui est précisément le problème décrit dans tout cet article.
Une action immédiate et peu coûteuse pour toute équipe éditoriale ou produit : instrumente dès maintenant la part de réponses génératives qui citent ta marque, avant que le trafic organique cesse d'être un proxy utilisable. On ne pilote pas ce qu'on ne mesure pas, et la métrique de remplacement n'existe encore par défaut nulle part.
À retenir : harnais, framework et MCP sont trois choses différentes que le marché confond. Le framework est la bibliothèque avec laquelle tu écris l'agent. Le harnais est le programme qui l'exécute réellement : il tient la boucle, la mémoire, l'appel d'outils, les permissions et la reprise après incident. MCP est le protocole par lequel le harnais parle aux ressources extérieures. La conséquence est brutale pour tes choix d'architecture : changer de modèle est facile aujourd'hui, changer de harnais ne l'est pas, parce que c'est lui qui contient ta politique de sécurité et ton coût.
Ce que ça signifie pour vous
Pour les développeurs et équipes techniques
Traite le harnais comme ta vraie dépendance stratégique et le modèle comme un composant interchangeable. Documente ta boucle, tes permissions et ta reprise sur incident indépendamment du fournisseur : c'est là que vivent ton coût et ta sécurité.
Mets les garde-fous dans le code, pas dans le prompt, sur le modèle de l'action.Guard de Webagent. Toute contrainte qu'un modèle peut reformuler finira par être reformulée.
Instrumente le coût par tâche et plafonne explicitement les tours d'agent. Le rendement des architectures multi-agents fait débat jusque chez ceux qui les construisent, et la variable qui se travaille vraiment est le contexte, pas le modèle.
Pour les décideurs et dirigeants
La question du corpus est devenue une question de passif. Si ton produit consomme des contenus tiers, retiens ce que montre cette procédure : une phrase écrite en interne finit citée dans un mémoire, des années plus tard, et pèse sur la caractérisation de l'intention. Ta politique d'acquisition de données s'écrit maintenant, pas au premier contentieux.
Exige de tes fournisseurs une rétention zéro contractuellement vérifiable, pas promise dans un billet de blog. La controverse sur la politique de données d'Anthropic a déplacé des comptes majeurs en quelques semaines.
Arrête de financer des pilotes d'agents sans critère écrit de passage en production. Le point dur des déploiements n'est plus de prouver que la technologie marche, c'est l'intégration au système existant, et c'est là que partent les budgets.
Pour l'écosystème français et européen
La France est en train de devenir un corpus sans être un marché. Elle reçoit AI Overviews et l'entraînement sur ses contenus, pas nécessairement les produits, la nouvelle Siri en étant l'illustration directe. Cette asymétrie est le vrai sujet de politique publique, davantage que le risque existentiel.
Le levier européen crédible est la distribution, pas la course au meilleur modèle. Mistral intégré à la Fenêtre intelligente de Firefox et exécuté dans les environnements Cloudera touche plus d'utilisateurs réels qu'un point de benchmark.
Et le levier réglementaire utile n'est pas celui qu'on croit. Pendant qu'on débat du risque existentiel, ce sont les textes ennuyeux qui mordent : l'exception de fouille de textes et de données, la réserve de droits lisible par machine, les obligations de transparence sur les sources. C'est là qu'un éditeur français a prise.
Le vrai signal de la période
Il n'est pas juridique, il est structurel.
Le doom loop n'est pas une pathologie du journalisme, c'est la conséquence normale de l'intermédiation, et elle frappe quiconque se retrouve sous la couche de réponse. Amazon bloquant l'agent de Meta prouve que le mécanisme remonte d'un étage, et que la liste des victimes inclut désormais des plateformes qui se croyaient du côté des extracteurs.
Pendant ce temps, le débat public regarde ailleurs. En Californie, un décret convoque des experts pour étudier un bouton d'arrêt d'urgence qu'aucun texte n'impose encore. À Washington, une proposition d'exemption antitrust permettrait aux laboratoires de se concerter sur la sécurité, et elle arrive au moment précis où la procédure expose ce que ces mêmes entreprises écrivaient en interne sur les dommages qu'elles causaient. Demander le droit légal de se coordonner quand on vient d'établir la connaissance privée du dommage est un calendrier difficile à tenir.
Cette dissonance n'est pas un hasard. On parle de dommages hypothétiques et lointains à l'instant où d'autres, déjà réalisés, sont chiffrés au dixième de point. Un risque futur se régule par des promesses. Un dommage mesuré se règle par des chèques.
Pour la France, tout tient en une phrase : refuser d'être un corpus qui n'est pas un marché.
Nos prédictions
| Prédiction | Horizon | Échéance | Confiance | Statut |
|---|---|---|---|---|
| Aucune exemption antitrust fédérale américaine dédiée à la coordination sur la sécurité de l'IA ne sera adoptée par le Congrès ; le sujet restera au stade de la proposition doctrinale ou du projet de loi non voté. | 1 an | 22 sept. 2027 | haute | En cours |
| OpenAI ou Microsoft signera avec un éditeur ou un groupement d'éditeurs français un accord de licence de contenus nouveau, c'est à dire conclu et rendu public après le 22 septembre 2026. | 6 mois | 22 mars 2027 | moyenne | En cours |
| Une plateforme de commerce ou de réservation comptant au moins dix millions d'utilisateurs mensuels annoncera publiquement le blocage d'un agent d'achat tiers nommé, sur le modèle du blocage de Muse par Amazon. | 3 mois | 22 déc. 2026 | moyenne | En cours |
| Au 22 mars 2027, la Californie n'aura adopté aucun texte imposant aux développeurs de modèles frontières un mécanisme d'arrêt assorti à la fois d'un seuil de déclenchement public chiffré et d'une autorité unique habilitée à l'activer. | 6 mois | 22 mars 2027 | moyenne | En cours |
| Au 22 mars 2027, la Fondation Wikimédia n'aura adopté aucune règle valable pour l'ensemble de ses projets sur la rédaction assistée par IA générative : la question restera tranchée édition par édition, comme aujourd'hui. | 6 mois | 22 mars 2027 | moyenne | En cours |
Une prévision n'est considérée comme réalisée ou invalidée que sur la base d'une annonce officielle, d'un document réglementaire, d'une documentation du fournisseur ou d'un incident publiquement documenté. À l'échéance, l'absence d'élément concluant la laissera non résolue.
Questions fréquentes
Qu'est-ce que le doom loop de l'IA ?▾
AI Overviews fait-il baisser le trafic des sites en France ?▾
Le fair use permet-il d'entraîner une IA sur des articles de presse ?▾
Pourquoi Wikipédia interdit-elle l'IA générative pour rédiger des articles ?▾
Qu'est-ce que le GEO et en quoi diffère-t-il du SEO ?▾
Sources
27 articles cités ci-dessous, sur 87 analysés sur la période (16 médias).
- OpenAI et Microsoft savaient qu'ils enclenchaient une « spirale de la mort » pour le web (The Verge AI)
- Un dirigeant de Microsoft qualifie le pillage de données par l'IA de « plus grand vol de travail de l'histoire » (Ars Technica AI)
- Les dirigeants de l'IA s'inquiètent de la menace existentielle pour les éditeurs de presse (The Information AI)
- L'IA entraînée sur le fair use vacille quand ses propres employés parlent de vol (The Decoder)
- Suno veut faire la paix avec l'industrie musicale, Sony et Universal attaquent de nouveau (Next INpact)
- AI Overviews : Google lance ses Aperçus IA dans la recherche en France (Next INpact)
- AI Overviews arrive en France : comment rester visible dans les résultats de recherche ? (FrenchWeb)
- « Ça donnait tout et n'importe quoi » : Wikipédia France prend une décision historique contre l'IA (Frandroid)
- Apple lance une Siri entièrement revue, basée sur Gemini, mais pas dans l'UE (The Decoder)
- Muse, l'agent IA de Meta, est interdit de faire les courses chez Amazon (Next INpact)
- Amazon se méfie de Muse, l'agent IA de Meta (The Verge AI)
- Google permet désormais à n'importe quel agent IA de piloter votre maison connectée (The Verge AI)
- Google ouvre la porte de sa maison connectée aux agents IA (Next INpact)
- Google annonce CC, un agent IA expérimental pour les familles (Ars Technica AI)
- Snap lance un outil IA pour Specs, disponible sur iOS et Mac (The Verge AI)
- OpenAI prépare des fonctionnalités pour contrer Grok Bot et étudie une réponse à Muse (The Information AI)
- Les développeurs trouvent des moyens d'utiliser Claude Code sans les modèles d'Anthropic (The Information AI)
- Contexte des agents chez LinkedIn : construire une couche de contexte organisationnel avec MCP (InfoQ AI)
- Les laboratoires d'IA ont un problème de confiance des données (The Decoder)
- Pourquoi la controverse sur la politique de données d'Anthropic profite à OpenAI (The Information AI)
- ADP et AWS s'allient pour sécuriser l'IA générative RH à grande échelle (Le Big Data)
- Mistral et Mozilla officialisent leur partenariat dans la Fenêtre intelligente de Firefox (Next INpact)
- Le PC portable de Perplexity est désormais disponible sous Windows, avec NVIDIA RTX (NVIDIA AI Blog)
- Agent-net publie en open source Webagent, un outil en Go qui transforme n'importe quel site en agent IA supervisé (MarkTechPost)
- Meilleurs frameworks d'agents open source pour LLM locaux en 2026 (MarkTechPost)
- DoorDash utilise des LLM multi-agents pour nettoyer 60 000 feature flags (InfoQ AI)
- Cloudera et Mistral s’associent pour déployer l’IA souveraine en entreprise (Le Big Data)
Corriger, compléter, contester
Cette analyse vous semble inexacte ou incomplète ? Dites-le-nous. Les retours sont lus un par un, et les plus utiles sont repris, avec votre accord, dans l'analyse suivante.
Les chiffres derrière l'analyse
Le Baromètre IA mesure chaque semaine qui domine la couverture médiatique — entités, concepts et tendances.
Suivi en continu
Cette analyse touche les sujets suivants — chaque hub agrège l'actualité quotidienne de l'entité.
Une analyse comme celle-ci chaque semaine
Abonnez-vous pour recevoir l'analyse hebdomadaire directement dans votre boîte mail.
Gratuit · 1 email le matin, l'essentiel de l'IA · désinscription en un clic